

AX · SILLOK / HARNESS
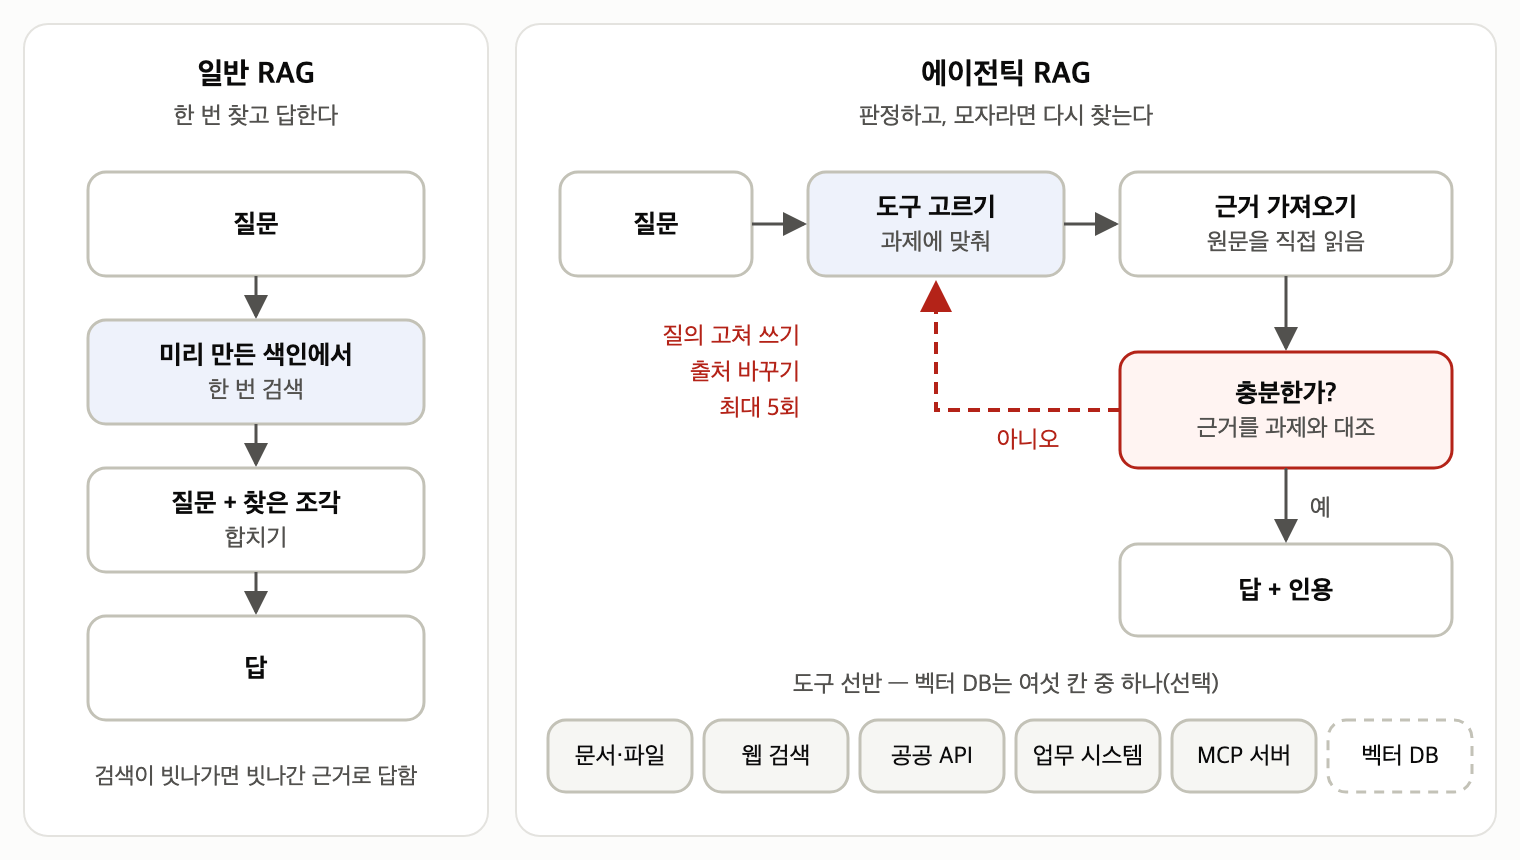
“RAG를 하려면 벡터 DB부터 깔아야 하나요?” 강의장에서 자주 받는 질문입니다. 벡터 DB를 먼저 깔면 문서 쪼개기, 임베딩 계산, 색인 관리가 함께 따라옵니다. ByteByteGo가 그린 「RAG vs Agentic RAG」 그림을 다시 보면 답이 보입니다. 왼쪽 RAG는 미리 만들어 둔 벡터·하이브리드 색인에서 한 번 찾고 답합니다. 오른쪽 에이전틱 RAG에서 벡터 DB는 도구 선반 위 여섯 개 가운데 하나일 뿐입니다. 그림의 중심은 “근거가 과제에 충분한가?”를 묻고, 모자라면 질의를 고쳐 쓰거나 출처를 바꾸는 붉은 점선 고리입니다.
결론부터 말씀드리면, 일반인이 에이전틱 RAG를 쓰는 데 벡터 DB는 필수가 아닙니다. 에이전틱 RAG의 원형 논문들은 위키백과 API와 키워드 검색(BM25)으로 출발했습니다. 2026년의 통제 실험들은 작은 자료에서 파일을 직접 뒤지는 에이전트가 벡터 검색보다 정확했다고 보고합니다.
제 Sillok(컨설팅·강의에 쓰는 개인 AI 작업 체계)에서도 벡터 없는 같은 색인으로 시험해 보았습니다. 사업 문서 문장의 근거 법령을 찾는 정답률이 한 번 검색 12%, AI 독해 32%, 다시 찾는 고리 54%로 단계마다 올랐습니다. 다만 자료가 커지고 표현이 제각각일수록 벡터는 쓸모를 되찾습니다. 그 경계도 함께 적었습니다.
에이전틱 RAG의 핵심은 벡터 창고가 아니라 ‘찾고, 판정하고, 다시 찾는’ 고리입니다.
논문과 Sillok 실측은 벡터 없이 시작해 정확도를 올릴 수 있음을 보여 줍니다.
자료가 커지면 키워드 색인부터 주고, 표현 차이로 놓치면 벡터를 더합니다.
PART 01 · Frame에이전틱 RAG의 핵심은 창고가 아니라 고리입니다
RAG(검색증강생성)는 질문과 관련된 자료를 먼저 찾아 프롬프트에 붙이고, 그 자료를 근거로 AI, 즉 대규모 언어 모델(LLM)이 답하게 하는 방식입니다. ByteByteGo 그림의 왼쪽 흐름은 여덟 단계입니다. 질문이 들어오면 검색기가 색인에서 상위 몇 조각을 뽑고, 프롬프트 빌더가 질문과 조각을 합쳐 AI에 넘깁니다. 검색은 미리 정한 절차대로 한 번만 일어납니다. 그래서 답의 품질은 그 한 번의 검색이 맞았는지에 달려 있습니다.
오른쪽 에이전틱 RAG는 아홉 단계이고, 차이는 세 가지입니다.
- 도구를 고릅니다. 문서, 웹 검색, 고객관리 시스템, API, 모델 컨텍스트 프로토콜(MCP) 서버, 그리고 벡터 DB가 같은 선반에 놓여 있습니다.
- 근거를 판정합니다. 평가 에이전트가 가져온 근거를 과제와 대조합니다.
- 다시 찾습니다. 근거가 모자라면 질의를 고쳐 쓰거나 출처를 바꿉니다. 그림은 그 횟수를 “최대 5회”로 묶어 두었습니다.
비유하면 일반 RAG의 검색기는 ‘한 번 뽑아 주는 도서 검색대’입니다. 에이전틱 RAG는 ‘책을 펴 보고, 모자라면 다른 낱말과 다른 서가로 다시 가는 사서’입니다.
앞의 그림 1이 이 차이를 한 장에 보여 줍니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 구분 | 일반 RAG | 에이전틱 RAG |
|---|---|---|
| 검색 횟수 | 한 번(미리 정한 절차) | 근거가 충분할 때까지 여러 번(상한을 둠) |
| 검색 도구 | 미리 만든 색인 하나 | 과제에 맞춰 고름(문서·웹·API·DB·벡터 등) |
| 근거가 틀렸을 때 | 틀린 근거로 답함 | 판정 후 질의를 고치거나 출처를 바꿈 |
| 미리 할 일 | 색인 구축(벡터면 임베딩 계산) | 도구 연결과 판정 규칙 작성 |
| 비용 | 질문당 싸고 빠름 | 검색·판정을 반복하는 만큼 늘어남 |
표에서 보듯 에이전틱 RAG를 에이전틱하게 만드는 것은 검색기의 종류가 아닙니다. 판정하고 다시 찾는 고리입니다. 이 구분이 이 글 전체의 출발점입니다.
PART 02 · Origins에이전틱 RAG의 원형은 벡터 DB 없이 출발했습니다
“RAG는 벡터 DB”라는 연상은 근거가 있습니다. RAG라는 이름을 붙인 Lewis 등의 2020년 논문은 위키백과를 밀집 벡터로 색인하고 가장 가까운 문단을 찾는 방식이었습니다. 그런데 ‘검색을 반복하고 판정하는’ 계보는 다른 곳에서 자랐습니다.
고리의 원형 연구들이 쓴 도구를 표로 펴면 이렇습니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 연구 | 한 일 | 쓴 검색 도구 |
|---|---|---|
| ReAct(Yao 등, 2022) | 생각과 행동을 번갈아 내며 검색·문서 안 찾기·답하기를 반복 | 위키백과 웹 API |
| IRCoT(Trivedi 등, ACL 2023) | 추론 문장 하나를 쓸 때마다 다시 검색 | BM25 키워드 검색(Elasticsearch) |
| CRAG(Yan 등, 2024) | 평가기가 근거를 맞음·애매함·틀림으로 나누고, 틀리면 출처 변경 | 기존 검색기 + 웹 검색 |
| Adaptive-RAG(Jeong 등, 2024) | 질문 난도에 따라 검색 안 함·한 번·여러 번 중 선택 | 검색기는 그대로, 경로만 고름 |
IRCoT는 키워드 검색만으로도 다단계 질문 네 종에서 검색 성능은 최대 21점, 답의 정확도는 최대 15점 올렸습니다. ReAct 저자들은 외부 근거에 기대게 하자 지어낸 답이 줄었다고 보고했습니다. 판정을 모델 안에 학습시킨 Self-RAG, 이 흐름을 정리한 Singh 등의 서베이도 같은 계보에 있습니다.

이 계보가 말하는 것은 하나입니다. 에이전틱 RAG의 ‘에이전틱’은 검색기 위에 얹는 행동 방식이지, 특정 검색기를 요구하지 않습니다.
PART 03 · Retriever검색기는 단순해도 됩니다 — 똑똑한 쪽은 고리입니다
키워드 검색이 생각보다 강하다는 증거는 오래됐습니다. BEIR(Thakur 등, NeurIPS 2021)는 검색 모델을 18개 데이터셋에 추가 학습 없이 적용해 보았습니다. 결론은 “BM25가 여전히 강한 기준선”이었습니다. 밀집 벡터 모델은 학습하지 않은 분야에서 자주 BM25보다 낮았습니다.
키워드 검색의 약점도 오래 알려져 왔습니다. Furnas 등(1987)은 같은 대상을 두고 두 사람이 같은 낱말을 고를 확률이 모든 분야에서 20% 미만이라는 ‘어휘 문제’를 보고했습니다. 처방은 ‘무제한 별칭’, 즉 하나의 대상에 가능한 이름을 최대한 많이 붙이는 것이었습니다. 그런데 이 별칭 붙이기는 AI가 아주 잘하는 일입니다. Query2doc(Wang 등, EMNLP 2023)은 AI가 쓴 가상의 답 문서를 질의에 덧붙였습니다. 추가 학습 없이 BM25 성능을 3~15% 올렸습니다. 에이전트가 질의를 고쳐 쓰는 고리는 1987년의 처방을 그때그때 실행하는 장치인 셈입니다.
2026년에는 이 질문을 정면으로 다룬 연구가 잇달아 나왔습니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 연구 | 무엇을 비교했나 | 결과 |
|---|---|---|
| Clarke·Smucker, 「Boolean queries are all you need?」 | AI 검색 에이전트에 불리언(AND·OR) 검색 엔진만 줌 · TREC 2024 RAG 주제 86개 | NDCG@10(상위 10건의 검색 품질, 0~1) 0.6863 — 저자들은 많은 밀집·희소 1차 검색기보다 높다고 평가(탐색적 결과) |
| Tamang 등, 「Beyond Top-K」(READ) | 780쪽 정부 재무보고서 · 검증 질문 51개 | 임베딩 없는 에이전트 58.8%, 밀집 검색 15.7%(조정 후 35.3%). 같은 고리에 상위 k개 검색 도구를 주면 27.5% |
| Zeng 등, 「Rethinking Agentic RAG」 | AI가 논리식으로 쓴 검색 의도를 역색인(키워드 색인)에서 실행 | 강한 에이전틱 하이브리드 기준과 대등, 구축·운영 비용은 크게 낮고 지어낸 답은 줄었다고 보고 |
READ 연구에는 정직한 단서가 하나 붙어 있습니다. BM25만 쓴 검색도 READ와 통계적으로 구분되지 않았습니다. 저자들은 자기 결과가 ‘에이전트 대 키워드’가 아니라 ‘임베딩 기반 대 임베딩 없는 검색’을 가른다고 정리합니다. 표가 많은 재무 문서에서는 쪼갠 조각이 단위(억·천만)와 회계연도 머리글을 잃기 때문입니다. 숫자가 단위를 물려받는 머리글까지의 거리는 중앙값 13줄이었습니다.
정리하면 이렇습니다. 검색기가 키워드 수준이어도, 질의를 고쳐 쓰고 원문을 다시 읽는 고리가 붙으면 벡터 검색에 밀리지 않는다는 보고가 쌓이고 있습니다.
PART 04 · Scale개인 규모에서는 ‘직접 뒤지는’ 에이전트가 가장 정확했습니다
그렇다면 자료가 얼마나 클 때까지 이 말이 맞을까요. 2026년 7월의 「BM25 Wins at Scale」(Wang 등)이 가장 직접적인 답을 줍니다. 시험 자료는 기업 문서 51만 1,959건과 질문 500개로 이뤄진 EnterpriseRAG-Bench입니다. 이를 28단계로 나눠 170만 토큰부터 6억 80만 토큰까지 키우며 같은 질문을 풀게 했습니다. 답을 쓰는 모델과 채점 방식은 고정했습니다.

가장 작은 단계에서는 파일 시스템을 직접 뒤지는 에이전트가 77.4점으로 가장 높았고, BM25가 74.7점, 밀집 벡터가 58.1점이었습니다. 약 1천만 토큰에서 순위가 뒤집혀, 전체 규모에서는 BM25 50.5점, 파일 탐색 에이전트 30.7점, 밀집 벡터 29.9점이었습니다. 파일 탐색 에이전트는 질문당 토큰을 39배 더 썼습니다. 흥미로운 대조 실험도 있습니다. 같은 에이전트에 파일 도구 대신 BM25 검색 도구를 쥐여 주었습니다. 그러자 전체 규모에서 69.4점이 나왔습니다(150문항 표본, 같은 표본에서 파일 탐색 에이전트는 36.9점).
일반인에게 옮기면 이렇습니다. 이 연구에서 약 1천만 토큰 아래에서는 벡터 DB를 만들기보다 AI 에이전트가 폴더를 직접 뒤지게 하는 편이 정확했습니다. 자료가 그보다 커지면 에이전트에게 키워드 색인을 도구로 쥐여 주면 됩니다. 벡터는 그래도 놓치는 질문이 남을 때 더할 선택지입니다.
내 자료가 어느 쪽인지는 글자 수로 먼저 가늠할 수 있습니다. 다만 글자와 토큰의 비율은 언어와 모델마다 달라서, 정확히 재려면 쓰는 모델의 토큰 계산기를 써야 합니다. 참고로 제 용도별 RAG 하나의 본문은 수백만~2천만 자로, 이 전환점 언저리에 놓일 수 있습니다[추정].
현장의 움직임도 같은 방향입니다. Karpathy는 2026년 4월 「LLM Wiki」 구상을 공개했습니다. AI가 원문을 읽어 마크다운 위키와 목차 파일(index.md)을 관리하게 하는 방식입니다. 그는 이 방식이 “출처 100개, 문서 수백 쪽” 정도의 중간 규모에서 놀랄 만큼 잘 동작하고 임베딩 기반 RAG 기반시설이 필요 없다고 썼습니다. 동시에 위키가 커지면 제대로 된 검색이 필요하다고 덧붙이며, BM25와 벡터를 섞은 로컬 검색 도구를 예로 들었습니다.
개발 도구 쪽 사례도 있습니다. Claude Code를 만든 Boris Cherny는 초기 버전을 벡터 DB 기반 RAG로 만들었습니다. 이후 셸 도구로 코드를 직접 찾는 ‘에이전틱 검색’으로 바꿨고, 그쪽이 대체로 더 잘 동작했다고 밝혔습니다. 다만 그 근거는 공개된 벤치마크가 아니라 내부 평가와 체감이었다고 전해지므로, 증거보다는 실무 신호로 읽는 편이 맞습니다.
PART 05 · Sillok제 Sillok의 용도별 RAG는 벡터 DB 없이 돌아갑니다
Sillok은 제가 컨설팅·강의 업무에 쓰는 개인 AI 작업 체계입니다. 그 안의 용도별 RAG 가운데 원천과 평가 기록을 이 컴퓨터에 둔 일곱 개를 살펴봅니다.
- PMI 표준
- 공공 정보화사업 법령·기준
- 공공 AX 안내서
- PO·PM 표준과 공공 SW 가이드
- HRD·교수설계 표준
- 국방 SW사업 규정
- 공공 SW사업 법령
원천은 인스턴스마다 11종에서 144종, 본문은 550만 자에서 2,010만 자입니다. 일곱 개 모두 같은 엔진 파일 하나로 돌고, 이 엔진은 Python 표준 라이브러리만 씁니다. 벡터 DB도, 임베딩 모델도, GPU도 없습니다.
엔진의 이름은 llm-wiki입니다. Karpathy 구상을 로컬에 구현한 것입니다. 원문 조각, 용어집, AI가 쓴 한국어 위키 요약을 채널별 BM25로 따로 찾은 뒤 순위 융합(RRF)으로 합칩니다. 한국어 질문이 영어 원문을 찾도록 한→영 손사전을 두었습니다. Furnas의 ‘무제한 별칭’을 손으로 만든 셈입니다. 정확한 문구는 SQLite 전문 검색(FTS5)으로 쪽 단위까지 찾습니다. 모든 근거에는 [원천 §조 p.쪽] 형식의 인용이 붙습니다.
에이전틱 RAG의 부품도 이미 엔진 안에 있습니다.
- 판정 신호: 1위 근거의 점수가 기준(BM25 6.0)보다 낮으면 근거 팩 맨 위에 경고를 붙입니다. “관련 근거가 약합니다. 질의를 바꾸거나 fulltext 로 원문 표기를 확인하십시오.” ByteByteGo 그림의 붉은 점선 고리를 켜는 스위치입니다.
- 경로 선택: 질문에 도메인 낱말이 없으면 색인을 읽지 않고 침묵합니다. Adaptive-RAG의 ‘검색 안 함’ 경로와 같은 역할입니다.
- 학습 고리: 약한 결과를 낸 질의는 기록해 두었다가 사전·위키·평가셋을 보강하는 데 씁니다.
- 답변 규칙: 근거 팩만 쓰고 주장마다 인용을 붙입니다. 근거에 없으면 ‘미확인’으로 표시하고, 부족하면 부족하다고 답합니다.
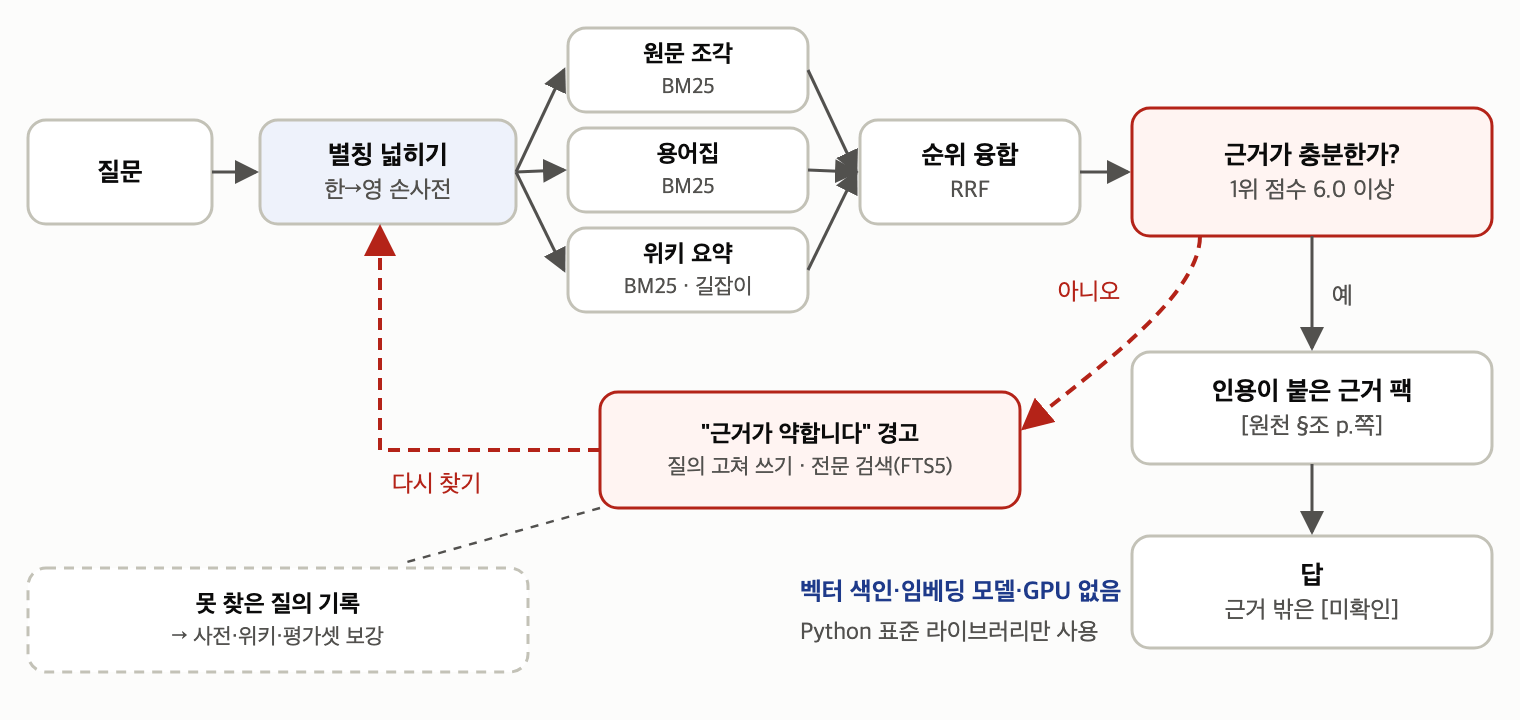
엔진의 평가 기록은 이렇습니다. 질문 하나를 찾는 데 3~19ms가 걸립니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 용도별 RAG | 원천 | 평가셋 | 1위 원천 적중 | 3위 안 쪽·조 적중 |
|---|---|---|---|---|
| PMI 표준 | 29종 | 질문 20개 | 95% | 85% |
| 공공 AX 안내서 | 63종 | 보류 질문 30개 | 83% | 87% |
| PO·PM 표준·공공 SW 가이드 | 11종 | 보류 질문 22개 | 82% | 82% |
| 공공 정보화사업 법령·기준 | 57종 | 보류 질문 40개 | 78% | 85% |
| HRD·교수설계 표준 | 48종 | 보류 질문 11개 | 64% | 82% |
| 국방 SW사업 규정 | 142종 | 봉인 문장 60개 | 5% | 8% |
| 공공 SW사업 법령 | 144종 | 봉인 문장 60개 | 15% | 18% |
‘보류 질문’은 사전과 위키를 다듬을 때 보지 않은 질문입니다. 마지막 두 줄의 ‘봉인 문장’은 성격이 다릅니다. 질문이 아니라 실제 공공 사업 문서(제안요청서)에서 떼어 온 문장 그대로입니다. 예를 들어 “이의신청 대상에 해당하는 경우 국가계약분쟁조정위원회 조정결정 분쟁을 해결할 수 있다”를 넣고, 근거 조항을 찾게 합니다. 사람은 법령 이름과 조항을 떠올려 다시 찾지만, 한 번 검색하는 파이프라인은 문장의 낱말을 그대로 맞춰 보다가 엉뚱한 문서를 1위에 올립니다. 정답률 5%와 15%는 일반 RAG가 무너지는 자리를 정확히 보여 줍니다.
PART 06 · Experiment같은 색인에 AI 독해와 ‘다시 찾는 고리’를 차례로 달았습니다
그래서 실험을 했습니다. 질문은 이 글의 주제 그대로입니다. 벡터를 더하지 않고 같은 키워드 색인에 AI 독해와 고리를 차례로 달면 무너진 자리가 얼마나 회복되는가.
두 봉인 평가셋에서 문장을 25개씩 무작위로 뽑았습니다(시드 7). 세 조건을 같은 문장, 같은 색인으로 비교했습니다.
- A · 한 번 검색: 문장을 그대로 검색해 1위 결과를 답으로 씁니다. 지금의 엔진 평가와 같은 방식입니다.
- B · 한 번 검색 + AI 독해: 같은 검색의 상위 결과를 AI가 읽고 하나를 고르거나 ‘근거 부족’이라고 답합니다. 교과서적인 일반 RAG입니다.
- C · 에이전틱 고리: AI가 네 도구(조·용어 검색, 쪽 단위 전문 검색, 원천 목록, 조문 읽기)를 골라 최대 5번 씁니다. 결과를 받을 때마다 “이 조항이 문장의 의무·정의·절차를 직접 정하는가”를 스스로 판정하고, 아니면 질의를 법령 용어로 고치거나 도구를 바꿉니다. 끝에 답하거나 ‘근거 부족’을 선언합니다.
B와 C의 AI는 Claude Sonnet 5.5이고, 제 개인 설정과 지침을 끈 깨끗한 상태로 불렀습니다. 채점은 정답 원천과 조항이 맞는지를 기계적으로 대조했습니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 조건 | 원천 적중(국방 · 공공 · 합계) | 조항까지 적중(합계) | 근거 부족 선언 | 틀린 답(원천 기준 · 조항 기준) | 질문당 AI 호출 · 시간 |
|---|---|---|---|---|---|
| A · 한 번 검색 | 4% · 20% · 12% | 6% | 0% | 88% · 94% | 0회 · 즉시 |
| B · 한 번 검색 + AI 독해 | 28% · 36% · 32% | 26% | 22% | 46% · 52% | 1회 · 약 5초 |
| C · 에이전틱 고리 | 52% · 56% · 54% | 40% | 0% | 46% · 60% | 3.7회 · 약 29초 |

벡터를 하나도 더하지 않았는데 원천 적중률이 12%에서 54%로 올랐습니다. 다만 이 상승을 고리 하나의 공으로 돌릴 수는 없습니다. 두 단계로 나뉘기 때문입니다. AI가 검색 결과를 읽고 고르기만 해도 32%가 됐고(A→B), 고리를 달자 다시 22%포인트가 올랐습니다(B→C). B→C 차이에는 재검색, 도구 선택, 조문 읽기가 함께 들어 있어 어느 하나의 효과로 나누지는 못했습니다. 문장 50개를 짝지어 보면 C만 맞힌 문장이 14개, B만 맞힌 문장이 3개였습니다. 이 정도 차이가 우연히 나올 확률은 약 1%입니다(부호 검정).
고리가 실제로 한 일은 단순했습니다. 에이전트는 질문당 평균 2.7번 도구를 썼고(최종 답변까지 합친 AI 호출은 3.7회), 대부분 ‘법령 용어로 고쳐 쓴 검색’과 ‘조문 읽기’의 조합이었습니다.
한 예를 들면 이렇습니다. 법령 이름이 빠진 “이 계약은 ○○에 따른 청렴계약제가 적용됩니다”라는 문장이 있었습니다. 한 번 검색은 엉뚱한 공고문을 1위로 올렸고, AI 독해는 ‘근거 부족’이라고 답했습니다. 에이전트는 질의를 “청렴계약제 청렴계약 특약 입찰 계약 부정행위 청렴서약”으로 고쳐 썼습니다. 이어 후보로 떠오른 국가계약법 제5조의2를 직접 읽어 대조한 뒤 답했습니다. 정답이었습니다. 1987년의 ‘무제한 별칭’과 그림 속 ‘근거를 과제와 대조’ 단계가 그대로 일어난 셈입니다.
다만 좋은 소식만 있지는 않았습니다.
원천 기준으로 센 틀린 답의 비율은 B와 C 모두 46%로 줄지 않았습니다. 조항까지 맞아야 정답으로 치면 틀린 답은 B 52%, C 60%로 오히려 늘었습니다. B는 전체 문장의 22%에 ‘근거 부족’이라고 답했지만, 에이전트는 한 번도 그렇게 답하지 않았습니다. 규칙에 “확신이 없으면 근거 부족”이라고 적어 두었는데도 그랬습니다. 틀린 답 23개 가운데 법과 시행령을 혼동한 ‘가까운 오답’은 1개뿐이었습니다. 고리는 맞는 근거를 더 많이 찾아 주지만, 스스로 더 신중해지지는 않았습니다.
그래서 인용을 붙이고 사람이 원문을 확인하는 단계는 여전히 필요합니다. 비용도 늘었습니다. 질문당 AI 호출은 1회에서 3.7회로, 시간은 약 5초에서 약 29초로 늘었습니다.
이 실험이 보여 주는 것은 ‘같은 키워드 색인에 고리를 달면 얼마나 달라지는가’까지입니다. 벡터 색인을 따로 만들어 비교하지는 않았으므로 ‘벡터보다 낫다’는 결론은 이 실험에서 나오지 않습니다.
문장은 평가셋마다 25개, 조건마다 한 번씩 돌렸고, 모델도 하나입니다. 정답표는 문장마다 조항 하나로 정해져 있어, 다른 조항도 근거가 될 수 있는 문장에서는 정답률이 낮게 잡혔을 수 있습니다.
PART 07 · Sources출처를 바꾸는 판단도 고리의 일입니다
ByteByteGo 그림의 붉은 글씨에는 ‘질의 재작성’과 함께 ‘출처 변경’이 적혀 있습니다. Sillok에서 이 판단은 여러 모습으로 나타납니다.
가장 분명한 실측은 지난 10월의 건강 질의응답 실험입니다. 같은 건강 질문 10개를 여러 엔진에 물었습니다. 제 강의 노트 안에서만 답하게 하면 클라우드 모델 평균이 3.38점(5점 만점)이었고, 웹 검색으로 출처를 넓히자 4.46점이었습니다. 이 실험은 출처 범위를 사람이 정해 준 비교였으므로, 에이전트가 스스로 출처를 고른 결과는 아닙니다. 그래도 같은 질문에 어떤 출처를 붙이느냐에 따라 점수가 달라졌다는 점은 보여 줍니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 출처 | Sillok에서 쓰는 도구 | 벡터 사용 | 고리에서 맡는 일 |
|---|---|---|---|
| 표준·법령 문서 | llm-wiki(BM25·전문 검색) | 없음 | 조·쪽 단위 근거와 인용 |
| 현행 법령 원문 | 국가법령정보센터 Open API | 없음 | 법령명으로 찾고 조문 원문을 받음 |
| 웹 자료 | 회수 사다리(캐시 → 수집 엔진 → 렌더링 → 로그인 브라우저 → 웹 검색) | 없음 | 막히면 다음 칸으로 출처·방법 변경 |
| 개인 노트 4만여 개 | 노트 직접 읽기(머리말 거르기 + 본문 grep) | 선택 | 기본은 글자 일치, 의미 검색은 있으면 더함 |
| 논문 | OpenAlex·arXiv·Semantic Scholar·Crossref API | 없음 | 논문 찾기와 인용망(참고·피인용) 확장 |
몇 가지는 설명이 필요합니다. 법령은 색인을 만들 필요조차 없었습니다. 국가법령정보센터의 Open API로 법령 이름을 검색해 일련번호를 받고, 그 번호로 조문 XML을 받으면 됩니다. 공공 API는 그 자체로 훌륭한 검색 도구입니다.
웹 자료의 회수 사다리에는 판정 규칙이 함께 붙어 있습니다.
- HTTP 200 응답만으로 성공이라 보지 않는다.
- 본문이 비어 있는 큰 HTML은 자바스크립트 껍데기로 의심한다.
- 사다리를 끝까지 내려가기 전에는 ‘접근 불가’라고 단정하지 않는다.
검색 결과뿐 아니라 검색 과정 자체를 평가하는 고리입니다.
개인 노트 검색은 벡터를 ‘선택 도구’로 두는 예입니다. 지난 7월 실측에서는 노트 4만 6,579개를 머리말 거르기와 본문 글자 검색으로 찾았습니다. 색인 캐시와 검색 묶기를 더하자 질의당 중앙값이 433ms였습니다. 둘 다 글자 일치 기반이었습니다. 이후 의미 검색 층을 더했지만, 그 층이 없거나 꺼져 있으면 조용히 글자 검색만으로 돌아가도록 만들었습니다. 벡터는 고리가 고를 수 있는 도구 하나이지, 고리를 돌리기 위한 전제 조건이 아닙니다.
PART 08 · Practice일반인은 이렇게 시작하면 됩니다
정리하면 일반인의 에이전틱 RAG에는 세 가지가 필요합니다.
- 이미 가진 검색 도구: 컴퓨터의 파일 검색, 메일 검색, 웹 검색, 법령·논문 같은 공공 API입니다. 새로 깔 것이 거의 없습니다.
- 도구를 고르고 반복할 수 있는 AI: 쓰는 환경에 따라 돌릴 수 있는 고리가 다릅니다. 아래 표를 참고하십시오.
- 판정 규칙을 적은 지침 파일: 무엇을 근거로 인정할지, 몇 번까지 다시 찾을지, 근거가 없으면 어떻게 말할지를 적습니다. 이것이 ByteByteGo 그림의 평가 에이전트입니다.
표 전체가 보이지 않으면 좌우로 이동해 보세요.
| 쓰는 환경 | 돌릴 수 있는 고리 | 한계 |
|---|---|---|
| 채팅 AI 앱에 파일 올리기 | 올린 파일 안에서 다시 찾기·판정, 웹 검색으로 출처 바꾸기 | 폴더 전체를 스스로 뒤지지 못함 |
| 프로젝트·지식 기능이 있는 AI 앱 | 넣어 둔 자료에서 반복 검색, 지침 칸의 규칙 적용 | 검색 방식은 앱이 정함 |
| Claude Code·Codex 같은 에이전트 | 폴더를 직접 열고 글자 검색·재검색, 규칙 파일 적용 | 터미널 사용에 익숙해야 함 |
자료가 PDF라면 먼저 텍스트나 마크다운으로 바꿔 한 폴더에 모읍니다. 변환은 poppler의 pdftotext 명령이나 PDF 뷰어의 텍스트 내보내기로 할 수 있습니다. 자료 규모는 그 폴더에서 cat *.md *.txt | wc -m 으로 글자 수를 세어 가늠합니다.
파일마다 한 줄 설명을 단 목차 파일을 하나 만들어 두면 좋습니다. Karpathy의 index.md와 같은 역할입니다. 그다음 지침 파일에 아래 규칙을 붙여 넣습니다. Claude Code라면 폴더의 CLAUDE.md, Codex라면 AGENTS.md, 일반 AI 앱이라면 프로젝트 지침 칸입니다.
[근거 찾기 규칙]
1. 답하기 전에 이 폴더의 목차 파일을 먼저 읽고, 관련 파일을 골라 원문을 직접 연다.
2. 찾은 원문이 질문에 직접 답하는지 스스로 판정한다. 비슷한 주제일 뿐이면 근거로 쓰지 않는다.
3. 근거가 모자라면 낱말을 바꿔(동의어·공식 용어·영어 표기) 다시 찾는다.
   폴더에 없으면 공식 출처(법령 API, 기관 누리집, 논문 데이터베이스)로 출처를 바꾼다.
4. 다시 찾기는 최대 5번까지 한다. 그래도 없으면 "확인하지 못했다"고 답한다.
5. 주장마다 파일명과 쪽(또는 URL)을 붙인다. 근거 밖의 추측은 [추정]이라고 표시한다.
6. 근거로 쓴 원문 문장을 따옴표로 그대로 옮겨 붙인다.
6번은 제 실험에서 얻은 보완입니다. “확신이 없으면 근거 부족”이라는 규칙만으로는 에이전트가 모른다고 답하지 않았습니다. 원문 문장을 그대로 붙이게 하면 적어도 사람이 대조할 수 있습니다. 이 보완의 효과는 따로 재지 않았습니다.
규칙을 붙인 뒤에는 질문 세 개로 고리가 실제로 도는지 확인합니다.
- 답을 이미 아는 질문: 정답과 인용이 함께 나와야 합니다.
- 자료와 다른 낱말로 물어야 찾을 수 있는 질문: 다시 찾은 흔적이 있어야 합니다.
- 자료에 답이 없는 질문: “확인하지 못했다”가 나와야 합니다.
AI가 적어 준 검색 순서만 믿지는 않습니다. 에이전트라면 실제 도구 실행 기록을 보고, 인용은 원문을 직접 열어 대조합니다.
PART 09 · Limits벡터가 필요한 순간과 이 글이 말하지 못하는 것
벡터 DB가 쓸모없다는 이야기는 아닙니다. 다음 네 경우에는 벡터를 도구 하나로 더할 만합니다.
- 자료가 커질 때: 「BM25 Wins at Scale」에서 파일을 직접 뒤지는 에이전트는 약 1천만 토큰을 넘자 BM25에 역전당했습니다. 이때는 키워드 색인을 먼저 도구로 주고, 그래도 놓치는 질문이 있으면 벡터를 더합니다. Anthropic의 「Contextual Retrieval」 실측에서는 조각마다 문맥 설명을 붙인 임베딩과 BM25를 함께 쓰자 상위 20개 조각에서 근거를 놓치는 비율이 49% 줄었고, 재순위까지 더하면 67% 줄었습니다.
- 표현이 제각각일 때: 같은 뜻을 전혀 다른 낱말로 쓰는 자료, 여러 언어가 섞인 자료에서는 별칭 붙이기의 품이 커집니다. Sillok의 한→영 손사전도 계속 손봐야 하는 비용입니다.
- 빠르고 싸야 할 때: 고리는 공짜가 아닙니다. 파일 탐색 에이전트는 질문당 토큰을 39배 썼습니다. Anthropic의 다중 에이전트 리서치 시스템 분석도 같은 점을 보여 줍니다. 웹 탐색 평가(BrowseComp)에서 토큰 사용량 하나가 성능 차이의 80%를 설명했습니다. 더 많이 찾을수록 더 잘 맞히지만 그만큼 비쌉니다. 수천 명이 동시에 쓰는 서비스라면 계산이 달라집니다.
- 구조가 없는 자료일 때: 「Corpus2Skill」(Sun 등, 2026)은 기업 지식을 목차형 구조로 바꿔 탐색하게 했습니다. 11개 데이터셋에서 5개는 이겼고 3개는 비겼고 3개는 졌습니다. 주제 구조가 없는 사실 질문 모음에서는 평평한 검색이 낫다고 저자들은 정리합니다.
웹을 출처로 쓸 때의 위험도 적어 둡니다. 웹 문서에는 질이 낮은 글과 AI를 속이려는 문장이 섞여 있습니다. 판정 규칙과 인용 표기는 이런 근거를 걸러 내는 마지막 장치이므로 생략하지 않습니다.
이 글의 한계도 밝힙니다. 제 실험은 문장 50개, 모델 하나, 한 번 실행이고 벡터 기준선이 없습니다. 2026년 논문 다섯 편은 arXiv 프리프린트이고 동료 심사 여부는 확인하지 않았습니다. 「Boolean queries」 저자들은 시험 문서가 모델 학습 기간에 공개돼 있었다며 결과를 탐색적이라고 했습니다. Claude Code 사례는 2차 보도로 전해진 발언입니다. 수치는 각 연구의 설정 안에서만 읽어 주십시오.
PART 10 · Closing세 줄로 다시, 그리고 이번 주에 할 일
에이전틱 RAG의 본체는 벡터 창고가 아니라 찾고, 판정하고, 다시 찾는 고리입니다.
벡터 없이 시작해 정확도를 올릴 수 있었고, 충분한지는 내 질문과 허용 오류로 확인합니다.
자료가 커지면 키워드 색인부터 주고, 표현 차이로 놓치는 질문이 남으면 그때 벡터를 더합니다.
이번 주에는 자주 들여다보는 자료 한 묶음(계약서, 표준 문서, 강의 노트 무엇이든)을 텍스트로 바꿔 한 폴더에 모아 보시기 바랍니다. 목차 파일 한 장과 위의 「근거 찾기 규칙」을 붙이면 시작할 수 있습니다. 첫 질문은 “이 폴더 자료만 근거로 답하고, 찾은 순서와 근거 원문을 같이 적어 줘”로 하고, 위의 세 질문으로 확인합니다.
함께 읽으면 좋은 글입니다.
- 30시간 RAG 실측 회고 — Karpathy의 llm-wiki는 내 10년 obsidian-vault를 이길 수 있었나
- LLM이 내 노트 4만 개를 검색하는 두 가지 방법 — ‘직접 읽기’ vs ‘전용 CLI’ 실측
- Claude·OpenAI·Apple·Qwen 엔진 11개, 건강 질문 답변 310건으로 잰 질의응답 품질과 비용
「기업 RAG 운영 교훈」 시리즈
- 입구 글: 사내 RAG는 벡터 DB보다 ‘다시 찾는 고리’가 먼저입니다 (이 글)
- 1편: 사내 RAG는 근거를 먼저 넣고, 모자랄 때만 찾으러 보내십시오
- 2편: 사내 RAG를 늘리기 전에 인용 점검기와 퇴역 기준부터 다십시오
- 3편: 사내 RAG 근거는 사실을 더할 뿐 권한을 더하지 않습니다
짝 시리즈 · 경험으로 배운 하네스 운영 교훈
- AI 에이전트가 느리다는 불만, 모델보다 왕복 수부터 세십시오
- AI 에이전트 비용은 토큰 총량이 아니라 성공 작업당 비용으로 봅니다
- AI 가드레일은 지침 문장이 아니라 집행 장치입니다
- AI 운영 대시보드를 늘리기 전에 ‘끄면 무엇이 달라지는가’를 물으십시오
- 기업 AI의 기억은 쌓기보다 꺼내는 길이 먼저입니다
- 특별편: AI가 코드를 쓰는 회사에 필요한 개발 하네스
참고 자료
- ByteByteGo, 「RAG vs Agentic RAG」 도해.
- Lewis, P. 외, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020.
- Yao, S. 외, ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023.
- Trivedi, H. 외, Interleaving Retrieval with Chain-of-Thought Reasoning for Knowledge-Intensive Multi-Step Questions, ACL 2023.
- Asai, A. 외, Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection, 2023.
- Yan, S.-Q. 외, Corrective Retrieval Augmented Generation, 2024.
- Jeong, S. 외, Adaptive-RAG: Learning to Adapt Retrieval-Augmented LLMs through Question Complexity, NAACL 2024.
- Singh, A. 외, Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG, 2025(v4 2026).
- Thakur, N. 외, BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- Furnas, G. W. 외, The Vocabulary Problem in Human-System Communication, Communications of the ACM 30(11), 1987.
- Wang, L. 외, Query2doc: Query Expansion with Large Language Models, EMNLP 2023.
- Wang, P. 외, BM25 Wins at Scale: A Scaling Study of Retrieval-Augmented Generation Paradigms, 2026 · 프리프린트.
- Tamang, S. 외, Beyond Top-K: Replacing Black-Box Retrieval with Interpretable Agentic Operations, 2026 · 프리프린트.
- Clarke, C. L. A.·Smucker, M. D., Boolean queries are all you need?, 2026 · 프리프린트.
- Zeng, Y. 외, Rethinking Agentic RAG: Toward LLM-Driven Logical Retrieval Beyond Embeddings, 2026 · 프리프린트.
- Sun, Y. 외, Corpus2Skill: Distilling Enterprise Knowledge into Navigable Agent Skills for QA and RAG, 2026 · 프리프린트.
- Anthropic, Introducing Contextual Retrieval, 2024.
- Anthropic, How we built our multi-agent research system, 2025.
- Karpathy, A., LLM Wiki (gist), 2026.
- X-1 AI/AX 2030 전략: McKinsey, BCG, Accenture, Deloitte, Gartner 교차 분석
- X-2 빅테크 리더십 격변과 AX 전략
- X-3 2026년 GitHub에서 주목할 프로젝트와 AI 전환 신호
- X-4 AI 에이전트 2026 상반기 대해부 — 지금 무슨 일이, 리더는 무엇을
- E-1 AI 네이티브 기업 전환 — CHO·PMO 재정의
- E-2 한국 기업 AX 2030 (Capstone)
- E-3 NH농협은행 SAFe 애자일 3년 — 페이스메이킹의 기록
- E-4 하나은행 × BCG 애자일 전환 — 두 개의 리듬으로
- E-5 네이버랩스 AKI — 하이브리드 애자일 PMO로 7개 제품을 한 박자로
- E-6 일곱 도메인 업무 흐름 지도 — 내 도메인의 게이트는 어디에 걸려 있나
- EO-1 우리 회사 업무, 어디까지 Agent에 맡길까
- EO-2 사내 RAG의 진짜 테스트: 부서 이동과 문서 개정을 견디는가
- EO-3 회의록에서 업무 등록까지: 중복 실행을 막는 Agent
- EO-4 Agent 성적표: 답변·업무 완료·재작업을 함께 재기
- EO-5 전문가의 지식은 어떻게 다음 프로젝트의 근거가 되는가
- EO-6 Agent 도입 30일, PMO는 무엇을 보고 계속할지 결정할까
- EO-7 Sillok × Astra/ultra: 시너지를 판정하는 업무 실험
- EO-8 공공 SI와 제조 SCM, 같은 Agent에서 달라지는 경계
- B-1 AI 시대 PM의 역할 변화: 팀 모드의 중요성
- B-2 AI 시대, PO·PM·PL과 사무직의 역할이 근본부터 바뀐다
- B-3 AI 시대, PM/PL의 역량이 근본부터 바뀌어야 하는 이유
- B-4 AI 시대의 PMBOK 8판 훈련 전략
- B-5 Agentic 시대, PM/PL과 엔지니어는 무엇을 준비해야 하는가
- B-6 AI 인재, 무엇을 준비할 것인가 — 11+1 역량 지도
- B-7 PO·PM·PL 역량 통합: 5-Domain × 3-Level
- B-8 역량은 합치고, 결정권은 나눕니다 — AI/AX 인재 역량정의서
- R-0 직군이 아니라 역할이다 — Agentic 팀의 다섯 원형
- K-1 Agentic 시대, PM의 온톨로지맵 — Obsidian을 통해 나만의 RAG를 만드는 법
- K-2 Karpathy의 LLM과 Obsidian 지식 결합
- K-3 Karpathy의 autoresearch: PM에서의 적용 사례
- K-5 Karpathy LLM OS 시각으로 본 AX PM/PL 역량 — Claude Code 소스 교차 분석
- K-6 30시간 RAG 실측 — Karpathy llm-wiki vs obsidian-vault 양강 비교
- K-7 구글 OKF·Obsidian Vault·llm-wiki — 무엇을 어떻게 시작할까
- K-8 Obsidian × LLM 4만 노트 — 개인 RAG 최종 아키텍처 5층
- K-9 PM 온톨로지맵 템플릿 배포판 — 30분에 채우는 5칸
- K-10 기업 RAG 운영 교훈 입구 — 벡터 DB보다 다시 찾는 고리 · 정답률 12%→54%
- K-11 기업 RAG 운영 교훈 1 — 먼저 넣고 모자랄 때 찾기 · AI 호출 43% 절감
- K-12 기업 RAG 운영 교훈 2 — 인용 점검기·퇴역 기준 · RAG 8개 운영 기록
- K-13 기업 RAG 운영 교훈 3 — 근거는 권한을 더하지 않는다 · 숨은 지시 실험
- G-1 삼성전자 GAUSS PM Agent: 효과적 설계로 주니어 PM 지원하기
- G-2 주니어 PM 위한 AI 하네스 구축 가이드
- G-4 삼성 DX 엔지니어를 위한 Codex 온보딩 — 하네스 & 개인 RAG
- G-5 나의 Agent 비서, 블록 12개로 조립한다 — 재사용 블록과 77%의 법칙
- G-6 내 업무를 맡길 AI 에이전트 — 6블록 설계와 PROFILE BIND
- CC-4 내 노트 4만 개 검색 — LLM 직접 읽기 vs 전용 CLI, 하이브리드 5.5배
- CC-5 Obsidian 노트를 앱 없이 검색 — 오픈소스 byeori(벼리)
- CC-6 사내 지식을 RAG로 — 망분리·토큰0 6단계
- G-8 4.5TB 클라우드 단일화 — Mac × 클라우드 × Agentic 업무환경
- A-5 Fable 5와 보낸 첫 하루 — 모델 × 하네스 × RAG 실측 회고
- A-6 맥은 이미 AI 워크스테이션 — 사진·노트·인박스 0원 정리
- A-7 Mac@Work 2026 — 맥 20년차의 도구 모음과 Agentic 카테고리
- A-8 좋은 엔진은 없다, 맞는 엔진이 있다 — Codex/Sol vs Claude/Fable 5대 실전 비교
- A-9 프롬프트는 형식을, 사내 RAG는 판단을 채웠습니다 — PMO 문서 2×2 실험
- A-10 Claude·OpenAI·Apple·Qwen 엔진 11개로 잰 질의응답 품질과 비용 — 답변 310건 실측
- CC-3 Opus xhigh 솔로 vs ultracode 멀티에이전트 — 작업유형별 A/B 실측
- G-3 대기업 직장인을 위한 AI Agent & Skill 추천 가이드 2026
- G-7 녹취 엔진 두 레인 — SpeechAnalyzer와 Alt, 코칭·컨설팅 6장면 판단표
- CC-7 Claude Code × GPT-5.6 Sol — CCR vs 순정 Codex 7시나리오 실측
- P-0 7인의 사고 체계 종합 프레임워크
- P-1 PM 코치가 바라보는 AI 전문가 탐구 1편: Andrej Karpathy
- P-2 Sutskever: 압축이 곧 지능이다
- P-3 Hassabis: 제1원리 분해
- P-4 LeCun: 세계 모델 + 예측
- P-5 Hinton: 거버넌스 + 자기부정
- P-6 Ng: AI 전환 플레이북
- P-7 Fei-Fei Li: 인간중심 설계
- P-8 Builders 종합: Boris·Cat·Truell·Masad·Murati·Brockman
- P-9 Operators 종합: Altman·Amodei·Nadella·Pichai·Zuckerberg·Suleyman
- P-10 Hardware 양강: Jensen Huang · Lisa Su
- P-11 DeepSeek 량원펑 — 연속 학습의 공백과 하네스
- S-1 Agentic PM의 시대가 열리다 — LG전자 SW PM 워크숍을 마치며
- S-2 삼성전자 PMC: AI와 함께하는 PM 교육 혁신
- S-3 SKT Agent 도출을 위한 AI 퍼실리테이션 기법
- S-4 리스크는 그릇이었다 — LG전자 SW공학연구소 GenAI RISK 워크숍
- S-5 코드 한 줄 없이 손익관리팀이 만든 에이전트 — 신한EZ손해보험
- S-6 “어디까지 입력해도 되나요?” — 삼성 구매 현장의 Agentic 각성
- S-8 ‘바이브 프로젝트 매니징’을 스스로 이름 붙였습니다 — 현대모비스 편
- S-9 “대충 시키면 다 해줄 줄 알았는데” — SK쉴더스 보안 PM들의 이틀
- S-16 “완료했습니다”가 서로 다른 뜻이었다 — 다섯 차수 종료 회고 NEW
- PS-2 공공 PM이 ‘AI 이용자’에서 ‘AI 활용자’로 — 아이티센 편
- S-17 기준 문서를 내 업무로 다시 쓰자 — FITI시험연구원 관리자 AX NEW
- S-18 PM·컨설턴트를 FDE로 세우는 실무 훈련 — KT DS AX PO·PM NEW
- S-19 근거로 검증하는 발주 담당자로 — 코레일 AX PMO NEW
- S-20 큰 그림은 표준으로, 상세는 AI로 — 삼성전자 AX PMC NEW
- S-21 내 Epic을 포트폴리오에 올리자 — LG전자 SW PM·리스크 NEW
- M-1 Agentic PM 시리즈 진입 가이드 — 전체를 한 장으로
- Z-1 실록(Sillok) — 5세기 Audit-Grade 거버넌스를 LLM 운영에 빌려온 한국형 LLMOS 하네스
- Z-2 실록(Sillok) 2026 상반기 결산 — RAG·고객사·지능화 루프·오픈소스
- Z-3 하네스×RAG 기업 컨설팅 — 네 현장·환각 방지·TOP10 자가진단·진화 루프
- Z-4 하네스 엔지니어링 백서 — Weng 하네스론×실록 구조 매핑·자기개선 루프·정직한 결산
- Z-5 에이전트 스킬 수명주기 백서 — Dynamic Agent Skills 8단×실록 매핑(7 온전+1 갭)·분기 12문항 레퍼런스·PO/PM/PL 컨설팅 직역
- Z-6 AX 시리즈 100편 기념 특집 — 실록·3층 RAG 운영 실측: 대시보드 5장 해설·구조 도식 2장·지식 구조 7층·강의/프로젝트/발행 3사례·응용분야·정지 사고 공개
- W-1 Agentic 월간 관전포인트 2026-05 — 가우스+빅테크 듀얼 모델 시대
- W-2 Agentic 2026 상반기 총결산 — 다섯 축 6개월
- Z-7 100편 기념 특집 2편 — 배치 사다리 6단·수명주기 22일/90일·계측 3지표 (팩 119 중 16개가 라우팅 80% 실측)
- Z-8 100편 기념 특집 3편 — 위임 경계=비가역성·88스텝 중 45개(51%) 사람 확정·비가역 6갈래·4칸 표 템플릿
- Z-9 하네스 운영 교훈 1 — 느린 턴은 왕복 수 · 794턴 실측 · 속도 계약·결정 요청 계약
- Z-10 하네스 운영 교훈 2 — 토큰 비용 · 캐시 95.7% · 가격표 빈칸 착시 · 성공 작업당 비용
- Z-11 하네스 운영 교훈 3 — 규칙↔집행 장치 원장 · 41개 중 21개 문장뿐 · 경고 1,698회 미전달
- Z-12 하네스 운영 교훈 4 — 관측 vs 엔진 · 운영 구성요소 1-in-1-out 예산 · 동결 나흘 뒤 초과
- Z-13 하네스 운영 교훈 5 — 에이전트 기억 회수 · 39% 미사용 · 4층 기억 · 한 원장
- Z-14 하네스 운영 교훈 특별편 — AI 주도 개발(AIDD) 가드레일 · DORA·METR·국내외 동향 · 도입 5단계